L’appel
Un membre de ma famille vit à l’étranger. Sur l’étagère trône un Raspberry Pi 5 avec Home Assistant, carte M.2, SSD NVMe, le tout bien rangé. Pas de SSH configuré, je n’en avais jamais eu besoin. Aucune possibilité de passer y jeter un œil. Mille deux cents kilomètres, c’est une distance désagréable pour un « regarde donc si la petite diode clignote ».
Et puis l’appel : l’interface ne répond plus.
J’ouvre le log et je vois un mur composé de la même ligne, des dizaines de fois d’affilée :
sqlite3.OperationalError: unable to open database fileAffaire pliée, me suis-je dit. La base du recorder est morte. Ce diagnostic était complètement faux et il m’a fallu deux jours pour m’en apercevoir. Le log était un témoin qui déposait avec beaucoup d’assurance en accusant le mauvais.
Pourquoi la base de données était innocente
SQLite rapporte ce que SQLite voit : j’ai voulu ouvrir le fichier, ça n’a pas marché. Sur la cause, le message se tait, et c’est précisément là que se cache le piège. On lit « database file » et on imagine une base corrompue. Le fichier se portait très bien. C’est le sol sous lui qui avait disparu.
Le système de fichiers avait été remonté en lecture seule. Read-only. Le noyau l’avait décidé tout seul, après que le disque a renvoyé une erreur d’E/S. ext4 dispose pour cela d’une gestion d’erreur documentée, errors=remount-ro, et c’est la valeur par défaut sur la grande majorité des systèmes : dès que le disque cesse de répondre de façon fiable, Linux arrête d’écrire. Un geste de protection avec une logique toute simple derrière. Mieux vaut ne rien écrire du tout qu’écrire n’importe quoi.
Pour Home Assistant, la conséquence est moche. Le processus tournait toujours. Il vivait en RAM, traitait des états, servait les intégrations, produisait des erreurs. La seule chose qu’il ne pouvait plus faire, c’était écrire. Ni le recorder, ni restore_state, ni un rechargement de configuration, et à un moment plus même la livraison propre du frontend. Ce qui m’est arrivé sous la forme « interface morte, base cassée » était un système qui parlait encore alors qu’il ne pouvait plus rien noter.
Cette confusion est la vraie leçon de toute l’affaire. Un système de fichiers read-only se présente dans les logs comme un problème de base de données. Ce dont il s’agit, c’est d’un signal matériel qui remonte trois couches plus haut sous les traits d’une erreur applicative.
J’ai quand même commencé par faire sagement l’évident. Vérifier la base, vouloir la remplacer, passer en revue les options du recorder. C’est le genre de travail qui donne l’impression d’avancer et qui ne fait pas gagner un millimètre. Avec le recul, ce qui aurait dû m’alerter, c’est que je n’arrivais même pas à supprimer la base. C’était une écriture, elle aussi. Le système m’a tendu la réponse pendant tout ce temps et je l’ai prise pour un message d’erreur.
L’avertissement qui collait trop bien
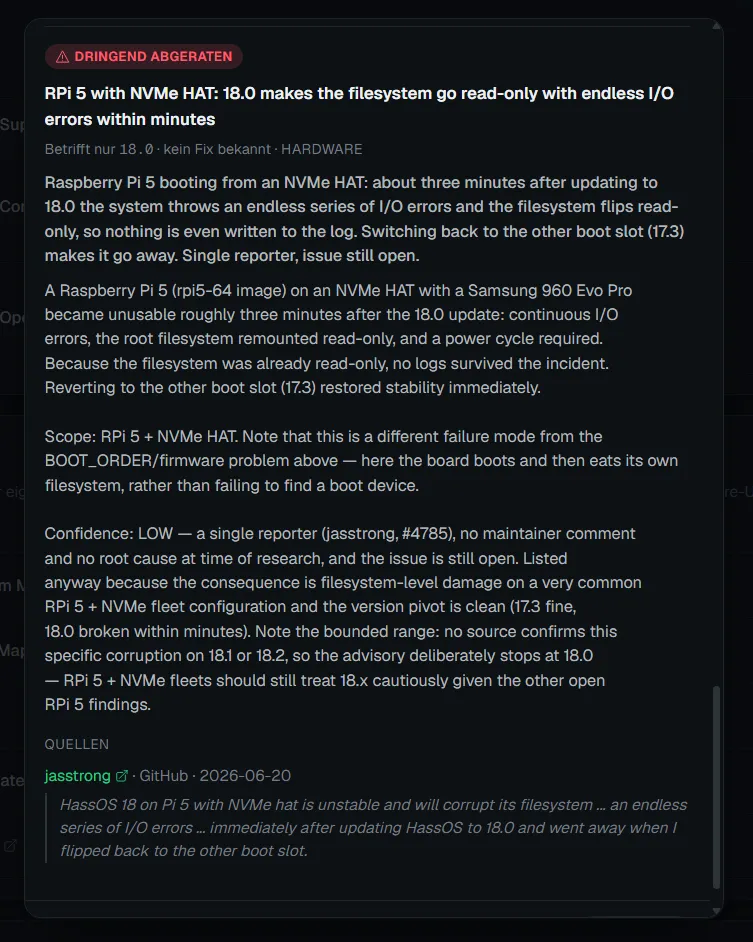
Peu avant, le système était passé à Home Assistant OS 18. Et dans ma propre plateforme dormait un avertissement, gravité « fortement déconseillé », catégorie matériel, dont le titre se lisait comme mon ticket :
RPi 5 with NVMe HAT: 18.0 makes the filesystem go read-only with endless I/O errors within minutes
J’ai relu cette fiche trois fois. Un Raspberry Pi 5 sur l’image rpi5-64, un NVMe sur la carte HAT et, environ trois minutes après la mise à jour vers 18.0, la machine devenait inutilisable : erreurs d’E/S en continu, système de fichiers racine remonté en lecture seule, coupure de courant obligatoire. Une phrase de l’avis m’a particulièrement remué, parce que j’avais moi-même déjà buté sur cet effet exact : « Because the filesystem was already read-only, no logs survived the incident. » Quelqu’un avait écrit mon histoire des mois avant que je la vive, y compris le passage sur le log qui cesse de noter.
Un second avertissement sur 18.0 figurait dans la même liste : le lien Ethernet filaire tombe et revient toutes les six à dix secondes, attribué à une régression du pilote macb dans le nouveau noyau 6.18, avec une interface qui se fige et des intégrations qui passent hors ligne. Pour quelqu’un dont l’interface est justement injoignable, ça sonne assez engageant aussi.
Donc l’évident. Downgrade en 17.3. C’était faisable à distance parce que j’avais récupéré les mises à jour en amont et téléversé le tout dans ma propre plateforme par précaution, ce qui a payé à cet instant précis.
Le problème est resté. Exactement pareil, exactement le même tableau d’erreurs, juste avec un autre numéro de version dans l’en-tête.
C’est là que la théorie se brise, sur un détail que j’ai failli survoler. Chez l’auteur de l’avis, le retour sur l’autre slot de démarrage avait rétabli la stabilité immédiatement. Chez moi, la panne est revenue telle quelle après le downgrade. Même symptôme, même mesure, résultat différent : le premier signal dur que je courais après le mauvais coupable malgré un avertissement qui collait à la perfection.
L’honnêteté impose d’ajouter que l’avis l’annonçait lui-même. Son niveau de confiance était explicitement marqué comme faible : un seul rapporteur, jasstrong, issue #4785 dans le dépôt operating-system, sans commentaire de mainteneur et sans analyse de cause racine. Je l’ai lu, j’en ai pris note, puis je l’ai écarté deux jours durant, parce que la théorie tombait tellement juste.
Voilà le vrai piège, et l’avertissement n’y est pour rien. Un symptôme a parfois plusieurs causes, et une correspondance à la ligne près reste une hypothèse, simplement une hypothèse bien habillée. Pour qui a exactement cette configuration, Pi 5 avec carte NVMe et fraîchement en 18.0, l’avis reste un avertissement à prendre au sérieux ; celui qui l’a signalé avait un Samsung dans la machine, rien de bas de gamme. C’était juste le cas de quelqu’un d’autre.
Ce genre d’impasse disparaît d’ordinaire des comptes rendus d’incident sans un mot. À la fin, chacun raconte son diagnostic comme une ligne droite, et les collègues confrontés au même problème se sentent bêtes quand ils tournent en rond pendant deux jours. Au moins, être détrompé m’a fait avancer plus que n’importe quelle confirmation : à partir de là, je savais que ça se jouait sous le système d’exploitation.
Le témoin qui se tait trop tôt
La percée est venue d’un endroit où je n’attendais rien du tout. J’ai regardé le journal du démarrage précédent, ce que crache journalctl -b -1. Pure panne d’idées, je n’avais tout simplement plus rien de mieux sous la main.
Et là, rien. Plus exactement : il y avait quelque chose, et puis ça s’arrêtait.
L’entrée se coupait en plein fonctionnement. Pas d’extinction, pas de message d’erreur, pas d’adieu. Le dernier horodatage se situait plusieurs heures avant les erreurs que Home Assistant avait signalées ensuite. Le log se terminait alors que le système tournait manifestement encore.
Il m’a fallu un moment pour comprendre ce que j’avais sous les yeux. Un log peut se terminer de deux façons : le système s’éteint, ou le système ne peut plus écrire. La première était exclue, puisque des messages sont arrivés après. Restait donc la seconde. À partir de cet horodatage, même journald n’arrivait plus à poser quoi que ce soit sur le disque. Le journaliseur propre du système, le service dont l’unique tâche est de noter, s’était tu pendant que tout le reste continuait.
C’est la preuve la plus dure de toute cette histoire, et elle est faite d’absence. Non pas d’une entrée, mais des entrées manquantes à partir d’un instant précis. Qui ne cherche que des messages d’erreur ne la trouvera jamais. Il faut regarder le trou.
Une fois qu’on l’a vu, tout se réordonne. Les dizaines d’erreurs SQLite étaient une réplique tardive. L’incident réel s’était produit des heures plus tôt, et la seule trace qu’il a laissée est le point où l’enregistrement s’arrête.
Le détail qui était déjà la réponse
Il y avait un second indice que j’ai bien trop longtemps rangé au rayon des curiosités.
Un redémarrage propre n’aidait pas. Le système remontait, tournait un moment, puis reglissait dans le même état. C’est seulement en tirant la prise, en coupant vraiment le courant et en rallumant, qu’on obtenait la paix pour un temps.
Cette différence mérite d’être prise au sérieux, car elle constitue presque le diagnostic complet. Un état logiciel, un processus figé, un montage coincé, un cache plein : rien de tout cela ne survit à un redémarrage. Un contrôleur de stockage qui s’est bloqué, si. Il garde son alimentation lors d’un démarrage à chaud et emporte son état cassé de l’autre côté. Quand seule la coupure de courant aide, le problème n’est pas dans le système d’exploitation. Il est sous le système d’exploitation.
J’ai chassé du logiciel pendant deux jours pendant que le matériel se tenait là, chaque fois la main levée, en disant : c’est moi.
Le coupable
Le SSD installé était un modèle sans marque, NXM-256 au format 2242. Ces disques sont étonnamment bon marché et, quand on cherche pourquoi, on trouve la raison dans la fiche technique : contrôleur MAXIO sans DRAM. Pas de cache propre, optimisé agressivement sur le prix.
Le reste fut du travail de fourmi assez triste. J’ai lu les avis clients de ce modèle précis, et c’était là, plusieurs fois, de gens différents, avec des mots différents : coupures, erreurs d’E/S, systèmes qui passent en read-only. Exactement mon tableau de panne, public, des mois avant mon coup de téléphone.
C’est la partie la plus désagréable de cette histoire. La réponse traînait depuis le début dans la zone d’avis d’une boutique en ligne. Deux étoiles, orthographe approximative, techniquement irréprochable, et moi j’ai lu des logs pendant deux jours à la place.
Je l’ai remplacé par un WD Green SN350. Rien d’excitant, et volontairement pas le modèle le plus rapide. Ce qui compte, c’est un contrôleur d’un fabricant qui accepte d’y mettre son nom, et une consommation faible. Le second point pèse davantage sur le Pi 5 : la carte M.2 officielle ne fournit qu’une puissance limitée et un NVMe grand public gourmand peut y sombrer sous charge dans l’instabilité qu’on voulait justement éviter. Depuis, c’est calme.
Ce qui m’a réellement aidé ici, et ce qui n’a rien fait
J’écris ce blog pour un produit, alors je dis franchement quelle part il a prise dans l’histoire.
L’agent de HA Fleet Manager est resté joignable alors que l’interface était morte. Ça m’a permis de redémarrer à distance, de mener le downgrade et surtout de continuer à lire les logs. Sans SSH, c’était le seul canal vers le système. Voilà toute sa contribution, et elle me suffit.
Rien d’héroïque là-dedans. L’agent n’a pas réparé le SSD, il ne m’a pas épargné le diagnostic et il ne m’aurait pas non plus évité l’impasse. Il a empêché exactement une chose : que la dernière option disponible soit « prendre la voiture ». À mille deux cents kilomètres, ça vaut beaucoup et rien de plus que ça. À quoi ressemble un tel accès quand on le construit proprement, je l’ai détaillé dans la maintenance à distance sans VPN et sans port ouvert.
Je retiens deux choses pour ma propre pratique. D’abord, mon regard sur le matériel de stockage bon marché est nettement moins aimable depuis cette affaire. Économiser trente euros sur le SSD d’une installation censée tourner des années s’achète au prix d’une recherche de panne qui coûte plusieurs fois ça. Pour les intégrateurs s’ajoute le fait qu’ils répondent de la pièce plus longtemps que le fabricant. Ensuite : tout ce que je déporte vers des réflexes qui vivent hors du serveur aurait continué de fonctionner pendant ces deux jours. Le Pi était mort ; la lumière n’avait pas à l’être.
Et la vraie chute
La maintenance à distance sans accès out-of-band a une propriété qu’on ne remarque qu’en situation critique : chaque redémarrage te coûte des preuves. Ce qui n’a pas été écrit sur le disque disparaît avec le reboot, et redémarrer est précisément ce que tout le monde fait quand quelque chose coince. Trois redémarrages, c’est souvent trois fois la piste effacée.
C’est exactement pour ça que cette entrée de journal tronquée valait si cher. C’était le dernier morceau de preuve à avoir survécu à un redémarrage. Et il n’a rien déclaré du tout.
Il s’est juste arrêté.