Der Anruf
Ein Familienmitglied von mir wohnt im Ausland. Auf dem Regal steht ein Raspberry Pi 5 mit Home Assistant, M.2-Erweiterung, NVMe-SSD, hübsch aufgeräumt. Kein SSH eingerichtet, weil ich es nie gebraucht hatte. Keine Möglichkeit, mal eben vorbeizufahren. Zwölfhundert Kilometer sind eine unangenehme Entfernung für „schau doch mal, ob die Kontrollleuchte blinkt”.
Und dann eben der Anruf: Die Oberfläche geht nicht mehr.
Ich schaue ins Log und sehe eine Wand aus derselben Zeile, dutzendfach, immer wieder:
sqlite3.OperationalError: unable to open database fileEin klarer Fall, dachte ich. Die Recorder-Datenbank ist hin. Diese Diagnose war komplett falsch, und ich habe zwei Tage gebraucht, um das zu merken. Das Log war ein Zeuge, der überzeugt aussagte und dabei den Falschen beschuldigte.
Warum die Datenbank unschuldig war
SQLite meldet, was SQLite sieht: Ich wollte die Datei öffnen, das ging nicht. Über die Ursache schweigt die Meldung, und genau da liegt die Falle. Man liest „database file” und denkt an eine korrupte Datenbank. Die Datei war aber völlig in Ordnung. Der Boden unter ihr war weg.
Das Dateisystem war schreibgeschützt eingehängt. Read-only. Der Kernel hatte das selbst entschieden, nachdem der Datenträger einen I/O-Fehler geworfen hatte. ext4 kennt dafür eine dokumentierte Fehlerbehandlung, errors=remount-ro, und die ist auf den allermeisten Systemen die Vorgabe: Sobald die Platte nicht mehr verlässlich antwortet, hört Linux auf zu schreiben. Eine Schutzhandlung mit einer schlichten Logik dahinter. Lieber gar nichts schreiben als Mist schreiben.
Für Home Assistant hat das eine hässliche Konsequenz. Der Prozess lief ja weiter. Er lag im RAM, hat Zustände verarbeitet, Integrationen bedient, Fehler produziert. Nur schreiben konnte er nichts mehr. Der Recorder nicht, restore_state nicht, ein Config-Reload nicht, und irgendwann auch die Auslieferung des Frontends nicht mehr sauber. Was bei mir als „UI tot, Datenbank kaputt” ankam, war ein System, das noch redete, aber nichts mehr aufschreiben konnte.
Diese Verwechslung ist die eigentliche Lehre des ganzen Vorfalls. Ein read-only-Dateisystem meldet sich in den Logs als Datenbankproblem. Gemeint ist ein Hardwaresignal, das drei Schichten weiter oben als Anwendungsfehler ankommt.
Ich habe trotzdem erst brav das Naheliegende gemacht. Datenbank prüfen, Datenbank ersetzen wollen, Recorder-Optionen durchgehen. Das ist die Art von Arbeit, die sich produktiv anfühlt und keinen Millimeter weiterbringt. Rückblickend hätte mich stutzig machen müssen, dass ich die Datenbank ja gar nicht löschen konnte. Auch das war ein Schreibvorgang. Das System hielt mir die Antwort die ganze Zeit hin, und ich habe sie für eine Fehlermeldung gehalten.
Die Warnung, die zu gut passte
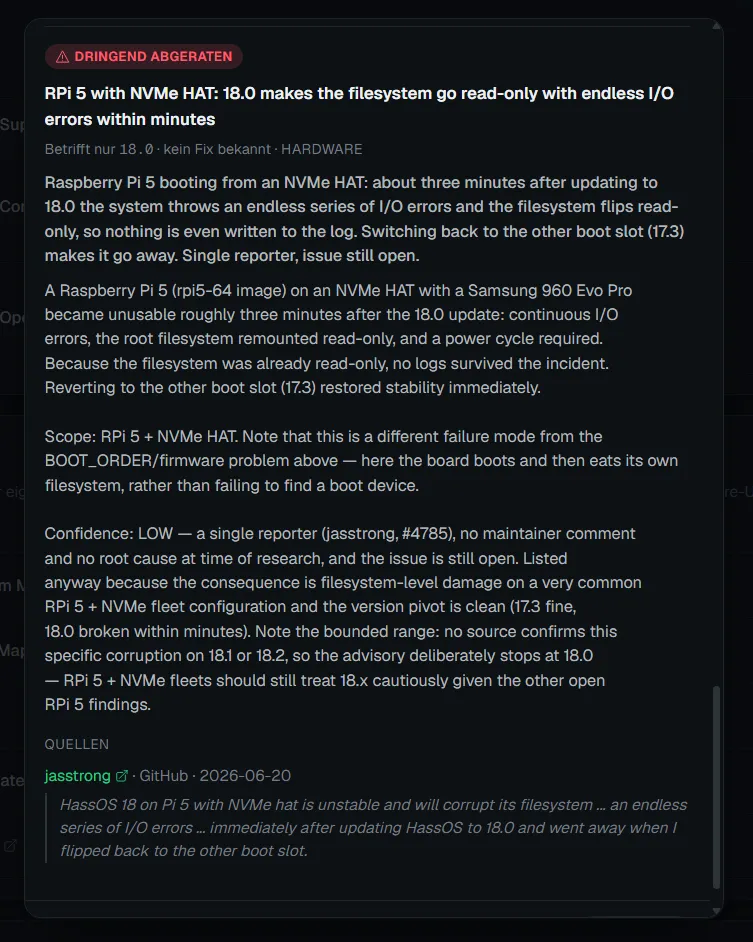
Kurz vorher hatte das System auf Home Assistant OS 18 aktualisiert. Und dazu lag in meiner eigenen Plattform eine Warnung, Schweregrad „Dringend abgeraten”, Kategorie Hardware, deren Titel sich las wie mein Ticket:
RPi 5 with NVMe HAT: 18.0 makes the filesystem go read-only with endless I/O errors within minutes
Ich habe die Karte dreimal gelesen. Ein Raspberry Pi 5 auf dem rpi5-64-Image, eine NVMe am HAT, und rund drei Minuten nach dem Update auf 18.0 war die Kiste unbrauchbar: fortlaufende I/O-Fehler, Root-Dateisystem read-only neu eingehängt, Power-Cycle nötig. Ein Satz aus der Advisory ging mir dabei besonders nah, weil ich über genau diesen Effekt schon selbst gestolpert war: „Because the filesystem was already read-only, no logs survived the incident.” Da hatte jemand Monate vor mir dieselbe Geschichte aufgeschrieben, samt der Stelle mit dem Log, das nichts mehr aufschreibt.
Parallel lag eine zweite Warnung zu 18.0 in derselben Liste: Der kabelgebundene Ethernet-Link flappt alle sechs bis zehn Sekunden, zurückgeführt auf eine Regression im macb-Treiber des neuen 6.18er-Kernels, mit einfrierender UI und Integrationen, die offline gehen. Für jemanden, dessen Oberfläche gerade nicht erreichbar ist, klingt auch das ziemlich einladend.
Also das Naheliegende. Downgrade auf 17.3. Das ging aus der Ferne, weil ich die Updates vorher gezogen und zur Sicherheit in die eigene Plattform hochgeladen hatte, was sich in genau diesem Moment auszahlte.
Das Problem blieb. Exakt gleich, exakt dasselbe Fehlerbild, nur mit einer anderen Versionsnummer im Header.
An dieser Stelle zerbricht die Theorie, und zwar an einem Detail, das ich beinahe überlesen hätte. Beim Melder in der Advisory hatte der Wechsel zurück auf den anderen Boot-Slot die Stabilität sofort wiederhergestellt. Bei mir kam das Fehlerbild nach dem Downgrade einfach wieder. Gleiches Symptom, gleiche Maßnahme, anderes Ergebnis: das erste harte Signal, dass ich trotz perfekt passender Warnung hinter dem falschen Täter her war.
Zur Ehrlichkeit gehört, dass die Advisory das selbst offengelegt hat. Der Vertrauensgrad war ausdrücklich als niedrig ausgewiesen: ein einzelner Melder, jasstrong, Issue #4785 im Operating-System-Repo, ohne Maintainer-Kommentar und ohne Ursachenanalyse. Das habe ich gelesen, zur Kenntnis genommen und danach zwei Tage lang beiseitegeschoben, weil die Theorie eben so gut passte.
Das ist die eigentliche Falle, und die Warnung kann nichts dafür. Ein Symptom hat manchmal mehrere Ursachen, und ein Treffer, der auf die Zeile genau sitzt, bleibt trotzdem eine Hypothese, nur eine im guten Anzug. Für Leute mit exakt dieser Konstellation, Pi 5 mit NVMe-HAT und frisch auf 18.0, ist die Advisory nach wie vor eine ernstzunehmende Warnung; der Melder dort hatte eine Samsung verbaut, also gerade keine Billigplatte. Mein Fall war es nur zufällig nicht.
Solche Sackgassen verschwinden in Fehlerberichten normalerweise stillschweigend. Am Ende erzählt jeder seine Diagnose als geraden Weg, und die Kollegen mit demselben Problem fühlen sich dann doof, wenn sie sich zwei Tage lang im Kreis drehen. Immerhin hat mich die Widerlegung weitergebracht als jede Bestätigung: Ab da wusste ich, dass es unterhalb des Betriebssystems liegt.
Der Zeuge, der zu früh verstummt
Der Durchbruch kam an einer Stelle, an der ich gar nichts erwartet hatte. Ich habe mir das Journal des vorherigen Boots angesehen, also das, was journalctl -b -1 ausspuckt. Reine Verlegenheit, mir fiel schlicht nichts Besseres mehr ein.
Und da war nichts. Genauer: Da war etwas, und dann hörte es auf.
Der Eintrag brach mitten im laufenden Betrieb ab. Kein Shutdown, keine Fehlermeldung, kein Abschied. Der letzte Zeitstempel lag mehrere Stunden vor den Fehlern, die Home Assistant später noch gemeldet hatte. Das Log endete, während das System nachweislich noch lief.
Es hat einen Moment gedauert, bis ich verstanden habe, was ich da sehe. Ein Log kann auf zwei Arten enden: Das System geht aus, oder das System kann nicht mehr schreiben. Ersteres war ausgeschlossen, denn danach kamen ja noch Meldungen. Also blieb nur das Zweite. Ab diesem Zeitstempel konnte selbst journald nichts mehr auf die Platte bringen. Der systemeigene Protokollierer, der Dienst, dessen einzige Aufgabe das Aufschreiben ist, war verstummt, während alles andere weiterlief.
Das ist der härteste Beweis in dieser ganzen Geschichte, und er besteht aus Abwesenheit. Nicht aus einem Eintrag, sondern aus dem Fehlen von Einträgen ab einem präzisen Zeitpunkt. Wer nur nach Fehlermeldungen sucht, findet ihn nie. Man muss auf die Lücke schauen.
Wenn man einmal darauf gestoßen ist, ordnet sich alles neu. Die dutzendfachen SQLite-Fehler waren ein spätes Nachbeben. Der eigentliche Vorfall lag Stunden davor, und die einzige Spur, die er hinterlassen hat, ist der Punkt, an dem die Aufzeichnung endet.
Das Detail, das schon die Antwort war
Es gab noch ein zweites Indiz, das ich viel zu lange als Kuriosität abgetan habe.
Ein sauberer Reboot half nicht. Das System fuhr hoch, lief eine Weile, und rutschte wieder in denselben Zustand. Nur wenn man den Stecker zog, wirklich stromlos machte und neu startete, war für eine Weile Ruhe.
Diesen Unterschied sollte man ernst nehmen, denn er ist beinahe schon die vollständige Diagnose. Ein Software-Zustand, ein hängender Prozess, ein verklemmter Mount, ein voller Cache: All das überlebt einen Reboot nicht. Ein Speichercontroller, der sich festgefahren hat, schon. Der bekommt bei einem Warmstart weiterhin Strom und behält seinen kaputten Zustand über den Neustart hinweg. Wenn ausschließlich das Trennen der Stromversorgung hilft, ist das Problem nicht im Betriebssystem. Es ist unter dem Betriebssystem.
Ich habe zwei Tage lang eine Software gejagt, während die Hardware jedes Mal mit erhobener Hand dastand und sagte: Ich bin’s.
Der Täter
Die verbaute SSD war ein No-Name-Modell, NXM-256 in Bauform 2242. Solche Platten sind erstaunlich günstig, und wenn man nachschaut, warum, findet man den Grund im Datenblatt: DRAM-loser Controller von MAXIO. Kein eigener Cache-Speicher, aggressiv auf Preis optimiert.
Der Rest war traurige Fleißarbeit. Ich habe die Produktbewertungen zu genau diesem Modell durchgelesen, und dort stand es, mehrfach, von verschiedenen Leuten, in unterschiedlichen Worten: Aussetzer, I/O-Fehler, Systeme, die read-only gehen. Exakt mein Fehlerbild, öffentlich einsehbar, Monate vor meinem Anruf.
Das ist der unangenehmste Teil dieser Geschichte. Die Antwort stand die ganze Zeit im Rezensionsfeld eines Onlineshops. Zwei Sterne, mäßige Rechtschreibung, fachlich vollkommen richtig, und ich habe stattdessen zwei Tage lang Logs gelesen.
Ersetzt habe ich sie durch eine WD Green SN350. Nichts Aufregendes, und bewusst nicht das schnellste Modell. Was zählt, ist ein Controller von einem Hersteller, der seinen Namen daran hängt, und eine geringe Leistungsaufnahme. Der zweite Punkt ist beim Pi 5 der wichtigere: Die offizielle M.2-Erweiterung liefert nur begrenzt Leistung, und eine hungrige Consumer-NVMe kann daran unter Last in genau die Instabilität laufen, die man eigentlich vermeiden wollte. Seitdem ist Ruhe.
Was mir hier tatsächlich geholfen hat, und was nicht
Ich schreibe diesen Blog für ein Produkt, also sage ich ehrlich, welchen Anteil es an der Geschichte hatte.
Der Agent von HA Fleet Manager blieb erreichbar, obwohl die UI tot war. Dadurch konnte ich aus der Ferne neu starten, das Downgrade fahren und vor allem die Logs weiter einsehen. Ohne SSH war das der einzige Kanal ins System. Das ist der ganze Beitrag, und er reicht mir.
Ein Heldenstück war das nicht. Der Agent hat die SSD nicht repariert, er hat mir die Diagnose nicht abgenommen und vor der Sackgasse hätte er mich auch nicht bewahrt. Er hat genau eine Sache verhindert, nämlich dass die einzige verbleibende Option „hinfahren” heißt. Bei zwölfhundert Kilometern ist das viel wert und trotzdem nicht mehr als das. Wie so ein Zugang aussieht, wenn man ihn sauber baut, habe ich beim Thema Fernwartung ohne VPN und ohne offenen Port im Detail aufgeschrieben.
Zwei Dinge nehme ich für die eigene Praxis mit. Erstens ist mein Bild von billiger Speicherhardware seit diesem Fall deutlich unfreundlicher geworden. Wer bei einer Anlage, die jahrelang laufen soll, an der SSD dreißig Euro spart, kauft sich eine Fehlersuche, die ein Vielfaches kostet. Für Integratoren kommt noch dazu, dass sie für das verbaute Teil länger geradestehen als der Hersteller. Zweitens: Alles, was ich in Reflexe außerhalb des Servers auslagere, wäre in diesen zwei Tagen weitergelaufen. Der Pi war tot, das Licht hätte es nicht sein müssen.
Und die eigentliche Pointe
Fernwartung ohne Out-of-Band-Zugang hat eine Eigenschaft, die einem erst im Ernstfall auffällt: Bei jedem Neustart verlierst du Beweise. Was nicht auf die Platte geschrieben wurde, ist mit dem Reboot verschwunden, und man startet ja gerne mal neu, wenn etwas klemmt. Dreimal neu gestartet heißt oft: dreimal die Spur verwischt.
Genau deshalb war dieser abbrechende Journal-Eintrag so wertvoll. Er war das letzte Stück Beweismaterial, das den Reboot überlebt hatte. Und er hat gar nichts ausgesagt.
Er hat nur aufgehört.