La llamada
Un familiar mío vive en el extranjero. En la estantería tiene una Raspberry Pi 5 con Home Assistant, placa M.2, SSD NVMe, todo muy ordenado. Sin SSH configurado, porque nunca me había hecho falta. Sin ninguna posibilidad de pasarme un momento. Mil doscientos kilómetros son una distancia incómoda para un «mira a ver si parpadea el piloto».
Y entonces la llamada: la interfaz ya no responde.
Abro el log y veo un muro con la misma línea, decenas de veces seguidas:
sqlite3.OperationalError: unable to open database fileCaso claro, pensé. La base de datos del recorder está frita. Ese diagnóstico era completamente falso y tardé dos días en darme cuenta. El log era un testigo que declaraba con enorme seguridad y señalaba al inocente.
Por qué la base de datos no tenía la culpa
SQLite informa de lo que ve SQLite: quise abrir el archivo y no pude. Sobre la causa, el mensaje calla, y ahí está justo la trampa. Uno lee «database file» y se imagina una base de datos corrupta. El archivo estaba perfectamente. Lo que había desaparecido era el suelo bajo él.
El sistema de archivos se había montado en solo lectura. Read-only. El kernel lo había decidido por su cuenta, después de que el disco lanzara un error de E/S. ext4 tiene para esto un manejo de errores documentado, errors=remount-ro, y en la inmensa mayoría de los sistemas viene por defecto: en cuanto el disco deja de responder de forma fiable, Linux deja de escribir. Un gesto de protección con una lógica muy simple detrás. Mejor no escribir nada que escribir basura.
Para Home Assistant eso tiene una consecuencia fea. El proceso seguía vivo. Estaba en RAM, procesaba estados, atendía integraciones, producía errores. Lo único que ya no podía hacer era escribir. Ni el recorder, ni restore_state, ni una recarga de configuración, y con el tiempo tampoco la entrega limpia del frontend. Lo que a mí me llegó como «interfaz muerta, base de datos rota» era un sistema que seguía hablando mientras ya no podía anotar nada.
Esa confusión es la verdadera lección de todo el episodio. Un sistema de archivos read-only se presenta en los logs como un problema de base de datos. Lo que hay debajo es una señal de hardware que llega tres capas más arriba disfrazada de error de aplicación.
Aun así, primero hice obedientemente lo evidente. Revisar la base de datos, intentar reemplazarla, repasar las opciones del recorder. Es ese tipo de trabajo que se siente productivo y no avanza ni un milímetro. Visto ahora, debería haberme escamado que ni siquiera pude borrar la base de datos. Eso también era una escritura. El sistema me tendió la respuesta todo el rato y yo la tomé por un mensaje de error.
El aviso que encajaba demasiado bien
Poco antes, el sistema se había actualizado a Home Assistant OS 18. Y en mi propia plataforma había un aviso, severidad «totalmente desaconsejado», categoría hardware, cuyo título se leía como mi propio ticket:
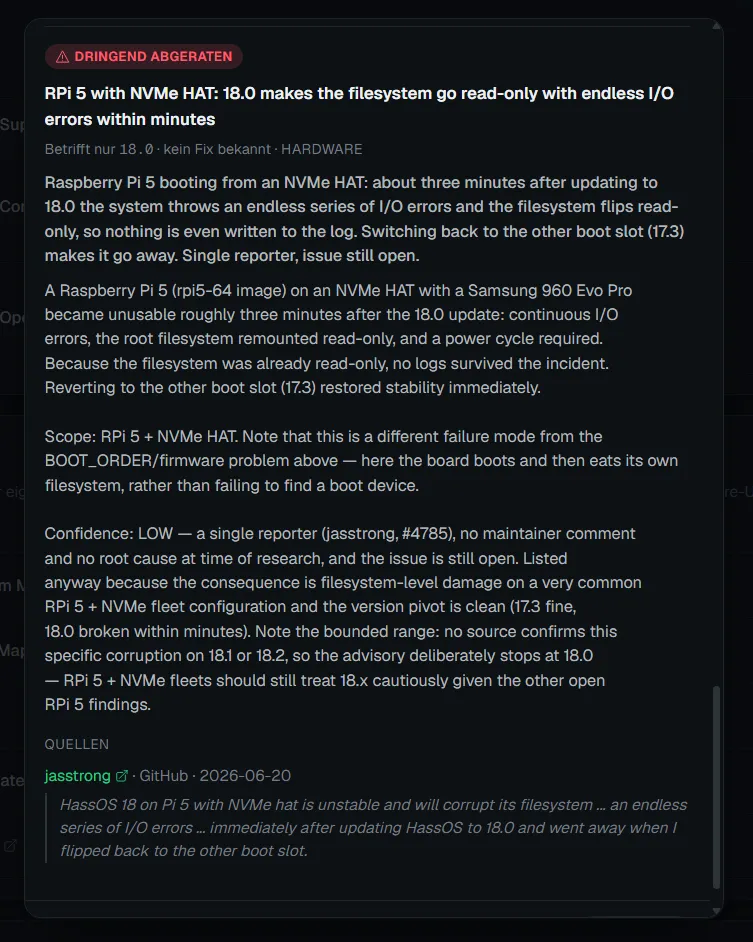
RPi 5 with NVMe HAT: 18.0 makes the filesystem go read-only with endless I/O errors within minutes
Leí esa tarjeta tres veces. Una Raspberry Pi 5 con la imagen rpi5-64, un NVMe en la placa HAT y, unos tres minutos después de actualizar a 18.0, el equipo quedaba inservible: errores de E/S continuos, sistema de archivos raíz remontado en solo lectura, ciclo de corriente obligatorio. Una frase del aviso me tocó especialmente, porque yo ya había tropezado con ese mismo efecto: «Because the filesystem was already read-only, no logs survived the incident.» Alguien había escrito mi historia meses antes de que yo la viviera, incluido el detalle del log que deja de anotar.
En la misma lista había un segundo aviso sobre 18.0: el enlace Ethernet por cable cae y vuelve cada seis a diez segundos, atribuido a una regresión del driver macb en el nuevo kernel 6.18, con la interfaz congelándose e integraciones que se van offline. Para alguien cuya interfaz justo está inaccesible, eso también suena bastante tentador.
Así que lo evidente. Downgrade a 17.3. Se pudo hacer en remoto porque había descargado las actualizaciones antes y las había subido a mi propia plataforma por seguridad, algo que se pagó solo en ese preciso momento.
El problema siguió. Igual de exacto, el mismo cuadro de errores, solo con otro número de versión en la cabecera.
Y aquí es donde se rompe la teoría, por un detalle que casi paso por alto. Al autor del aviso, volver al otro slot de arranque le devolvió la estabilidad de inmediato. A mí, el fallo volvió tal cual después del downgrade. Mismo síntoma, misma medida, resultado distinto: la primera señal dura de que estaba persiguiendo al culpable equivocado pese a una advertencia que encajaba a la perfección.
Por honestidad hay que añadir que el propio aviso lo dejaba claro. Su nivel de confianza estaba marcado explícitamente como bajo: un único informante, jasstrong, issue #4785 en el repositorio operating-system, sin comentario de ningún maintainer y sin análisis de causa raíz. Eso lo leí, tomé nota y luego lo aparté dos días, porque la teoría encajaba demasiado bien.
Esa es la trampa de verdad, y el aviso no tiene culpa alguna. Un síntoma puede tener varias causas, y un acierto que da en la línea exacta sigue siendo una hipótesis, solo que bien trajeada. Para quien tenga esa configuración precisa, Pi 5 con placa NVMe y recién puesta en 18.0, el aviso sigue siendo una advertencia que conviene tomarse en serio; el que informó allí tenía montado un Samsung, o sea nada de saldo. Simplemente resultó ser el caso de otro.
Estos callejones sin salida suelen desaparecer sin una palabra de los informes de incidencias. Al final cada cual cuenta su diagnóstico como una línea recta, y los colegas con el mismo problema se sienten tontos cuando pasan dos días dando vueltas. Al menos que me refutaran me llevó más lejos que cualquier confirmación: a partir de ahí sabía que la cosa estaba por debajo del sistema operativo.
El testigo que enmudece demasiado pronto
El avance llegó en un sitio donde no esperaba absolutamente nada. Miré el journal del arranque anterior, lo que escupe journalctl -b -1. Pura desesperación, sencillamente ya no se me ocurría nada mejor.
Y ahí no había nada. Más exacto: había algo, y luego se acababa.
La entrada se cortaba en plena operación normal. Sin apagado, sin mensaje de error, sin despedida. La última marca de tiempo estaba varias horas antes de los errores que Home Assistant había reportado después. El log terminaba mientras el sistema, demostrablemente, seguía funcionando.
Tardé un momento en entender lo que estaba viendo. Un log puede acabar de dos maneras: el sistema se apaga, o el sistema ya no puede escribir. Lo primero quedaba descartado, porque después siguieron llegando mensajes. Así que solo quedaba lo segundo. A partir de esa marca de tiempo, ni siquiera journald conseguía poner nada en el disco. El registrador propio del sistema, el servicio cuya única tarea es anotar, se había callado mientras todo lo demás seguía en marcha.
Esa es la prueba más dura de toda esta historia, y consiste en una ausencia. No en una entrada, sino en la falta de entradas a partir de un instante preciso. Quien busque solo mensajes de error no la encontrará jamás. Hay que mirar el hueco.
Una vez que lo has visto, todo se recoloca. Las decenas de errores de SQLite eran una réplica tardía. El incidente de verdad había ocurrido horas antes, y el único rastro que dejó es el punto donde se acaba la grabación.
El detalle que ya era la respuesta
Había un segundo indicio que durante demasiado tiempo despaché como una curiosidad.
Un reinicio limpio no ayudaba. El sistema arrancaba, funcionaba un rato y volvía a caer en el mismo estado. Solo cuando se tiraba del cable, cortando la corriente de verdad y arrancando otra vez, había paz durante un tiempo.
Esa diferencia hay que tomársela en serio, porque es casi el diagnóstico completo. Un estado de software, un proceso colgado, un mount atascado, una caché llena: nada de eso sobrevive a un reinicio. Un controlador de almacenamiento que se ha quedado atrancado, sí. Sigue recibiendo corriente en un arranque en caliente y se lleva su estado roto al otro lado. Cuando lo único que ayuda es cortar la alimentación, el problema no está en el sistema operativo. Está debajo del sistema operativo.
Me pasé dos días cazando software mientras el hardware estaba ahí cada vez con la mano levantada, diciendo: soy yo.
El culpable
El SSD montado era un modelo sin marca, NXM-256 en formato 2242. Esos discos son asombrosamente baratos y, si uno busca el porqué, lo encuentra en la hoja de datos: controlador MAXIO sin DRAM. Sin caché propia, optimizado con agresividad al precio.
El resto fue trabajo triste y minucioso. Me leí las reseñas de producto de ese modelo exacto, y ahí estaba, varias veces, de gente distinta, con palabras distintas: cortes, errores de E/S, sistemas que se quedan en read-only. Justo mi cuadro de fallo, público, meses antes de mi llamada.
Esa es la parte más incómoda de esta historia. La respuesta llevaba todo el tiempo en el campo de reseñas de una tienda online. Dos estrellas, ortografía regular, técnicamente impecable, y yo en cambio me pasé dos días leyendo logs.
Lo sustituí por un WD Green SN350. Nada espectacular, y a propósito no el modelo más rápido. Lo que cuenta es un controlador de un fabricante que le pone su nombre encima y un consumo bajo. Lo segundo pesa más en la Pi 5: la placa M.2 oficial entrega una potencia limitada y un NVMe de consumo hambriento puede meterse ahí bajo carga justo en la inestabilidad que uno quería evitar. Desde entonces, tranquilidad.
Qué me ayudó de verdad aquí, y qué no
Escribo este blog para un producto, así que digo con claridad qué parte tuvo en la historia.
El agente de HA Fleet Manager siguió accesible aunque la interfaz estuviera muerta. Gracias a eso pude reiniciar en remoto, hacer el downgrade y, sobre todo, seguir leyendo los logs. Sin SSH, era el único canal hacia el sistema. Esa es toda su aportación, y a mí me basta.
Heroicidad, ninguna. El agente no reparó el SSD, no me quitó el diagnóstico de encima y del callejón sin salida tampoco me habría librado. Impidió exactamente una cosa: que la última opción disponible fuera «coger el coche e ir». A mil doscientos kilómetros eso vale mucho y aun así nada más que eso. Cómo se ve un acceso así cuando se construye bien lo dejé escrito con detalle en mantenimiento remoto sin VPN y sin puerto abierto.
Dos cosas me llevo para mi propia práctica. Primero, mi opinión sobre el hardware de almacenamiento barato es bastante menos amable desde este caso. Ahorrarse treinta euros en el SSD de una instalación pensada para durar años se paga con una búsqueda de fallos que cuesta varias veces eso. Para los integradores hay además el problema de que responden por la pieza más tiempo que el propio fabricante. Segundo: todo lo que saco fuera hacia reflejos que viven fuera del servidor habría seguido funcionando durante esos dos días. La Pi estaba muerta; las luces no tenían por qué estarlo.
Y la gracia del asunto
El mantenimiento remoto sin acceso out-of-band tiene una propiedad que solo se nota en la emergencia: cada reinicio te cuesta pruebas. Lo que no se escribió en el disco desaparece con el reboot, y reiniciar es justo lo que hace todo el mundo cuando algo se atasca. Tres reinicios significan a menudo tres veces la pista borrada.
Precisamente por eso aquella entrada truncada del journal valía tanto. Era el último resto de material probatorio que había sobrevivido a un reinicio. Y no declaró absolutamente nada.
Solo se paró.